

llms.txt: что это за файл, кому нужен и как проверить в 2026 году
Александр Каширин
October 30, 2026
llms.txt — небольшой файл в Markdown, который предлагает AI-агенту краткое описание сайта и ссылки на важные документы. С его помощью совместимый агент может быстрее найти услуги, каталог, инструкции или правила работы. Но новый файл не заставляет ChatGPT рекомендовать компанию и не повышает позиции в Google сам по себе.
В 2026 году тема получила неожиданное продолжение. Google Search прямо пишет, что llms.txt ему не нужен, а Chrome Lighthouse уже проверяет этот файл в разделе Agentic Browsing. Это не противоречие в алгоритмах: Google Search и инструмент аудита браузера решают разные задачи. Разберём, что именно проверяется, покажем ошибку из реального отчёта PageSpeed Insights и приведём примеры для B2B-проектов.
Что такое llms.txt и как он работает
Автор формата, Джереми Ховард, опубликовал предложение 3 сентября 2024 года, а 10 августа 2026 года обновил его до версии 2. Полный текст — на официальном сайте llmstxt.org.
Идея отличается от привычной карты сайта. sitemap.xml помогает поисковым системам обнаруживать URL; robots.txt передаёт роботам правила доступа; llms.txt содержит выборочный маршрут к информации, полезной при выполнении задачи агентом. Подробности остаются на страницах, на которые ссылается файл.
Представьте оптового поставщика: у него десятки категорий, сотни брендов, условия заказа, доставки и способы связи. Когда агент отвечает на вопрос о поставщике, ему нужно отделить важные для покупки сведения от новостей и страниц фильтров. Хорошо составленный файл может подсказать, где искать данные. Но только если агент умеет его находить и использовать.
Что требует спецификация v2
Файл называется llms.txt и обычно доступен по адресу https://site.ru/llms.txt. В версии 2 он также может находиться в подразделе, например /docs/llms.txt, и описывать только документы под этим путём.
Структура выглядит так:
# Название проекта

> Кратко: чем занимается компания, для кого и что есть на сайте.

## Основные разделы

- [Каталог](https://example.com/catalog/): Товары и их характеристики
- [Доставка](https://example.com/delivery/): Условия получения заказа

## Optional

- [Блог](https://example.com/blog/): Дополнительные статьи
Обязателен только H1 с названием проекта; описание в цитате, группы H2 и списки ссылок рекомендуются для полезного файла. Optional обозначает второстепенные материалы, которые можно пропустить при ограниченном контексте. Ссылкам желательно давать короткие понятные пояснения. Не нужно выгружать в файл весь каталог или копировать в него страницы целиком.
Спецификация v2 также предлагает Markdown-версии содержательных страниц (например, /docs/manual.html.md) и связи с ними через rel="alternate"; связь страницы с подходящим llms.txt можно передать через rel="describedby". Эти механизмы полезны в совместимых агентных сценариях, но не обязательны для индексации в Google или Яндексе.
Почему PageSpeed Insights уже проверяет llms.txt
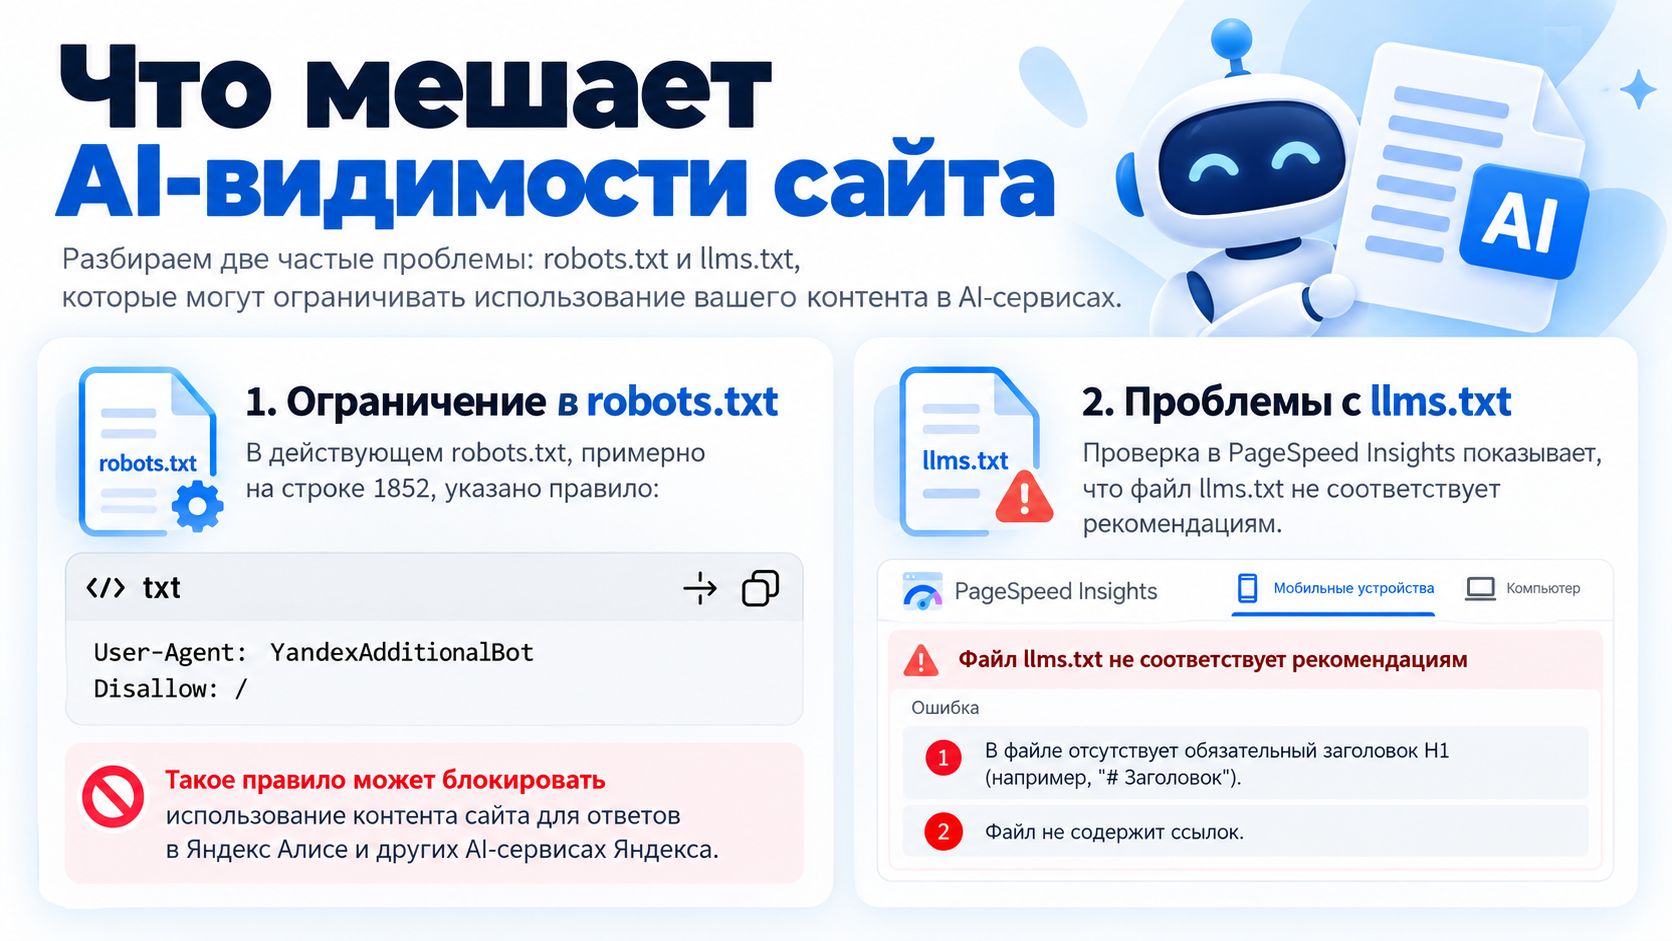
Мы получили отчёт PageSpeed Insights с предупреждением «Файл llms.txt не соответствует рекомендациям». Внутри указаны две ошибки: нет заголовка H1 и файл не содержит ссылок.
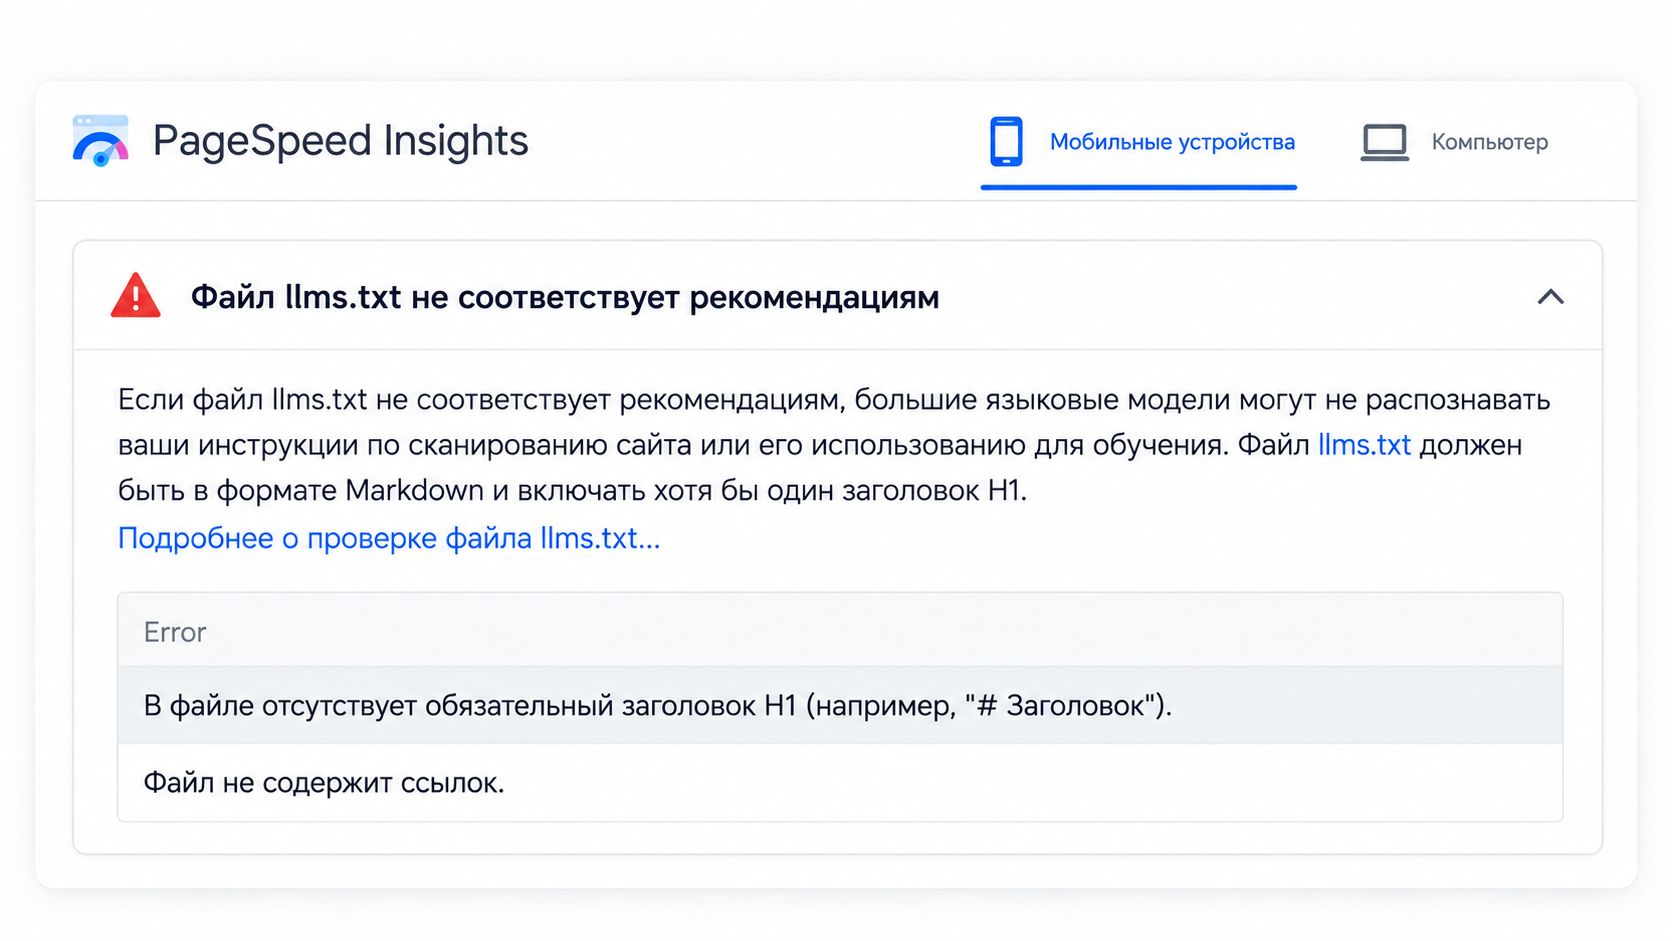
Самое важное здесь — различать отсутствие файла и ошибку его содержания.
В официальной документации Chrome Lighthouse этот аудит относится к Agentic Browsing. Google называет llms.txt развивающейся практикой. Если сервер возвращает 404 — файла нет, проверка помечается как N/A, потому что его наличие необязательно. Серверная ошибка при обращении к файлу, напротив, может быть отмечена аудитом.
Наш скриншот показывает ещё один тип диагностики: файл найден, но не соответствует ожидаемой структуре Markdown. Его нужно исправить как документ, если компания решила поддерживать формат.
Значит ли это, что Google стал ранжировать по llms.txt? Нет. Chrome Lighthouse проверяет удобство сайта для агентного просмотра, но это не сигнал ранжирования Google Search. В руководстве Google Search по AI-функциям прямо говорится: специальные llms.txt и другие AI-текстовые файлы не требуются, Google Search их не использует для повышения видимости или позиций. При этом другим системам никто не запрещает использовать этот формат.
Такой нюанс особенно важен при аудите: красное предупреждение в одном разделе PageSpeed Insights не означает штраф или потерю позиций в обычной выдаче.
Практический случай MENES: поисковая индексация есть, но Алиса AI не использует страницы
При анализе menes.ru мы столкнулись с ситуацией, которую легко ошибочно списать на отсутствие llms.txt или недостаток материалов в блоге: в обычном поиске страницы были представлены, а в ответах Алисы AI нужные сведения не появлялись.
Начали с технических ограничений и обнаружили в robots.txt прямой запрет:
User-agent: YandexAdditionalBot
Disallow: /
Такой блок запрещает YandexAdditionalBot использовать весь сайт в сценариях, на которые распространяются его правила. Справка Яндекс Вебмастера подтверждает: запреты для YandexAdditional и YandexAdditionalBot применяются, чтобы не показывать содержимое страниц в ответах Алисы AI. При этом, по описанию робота Яндекса, YandexAdditionalBot не является основным индексирующим роботом — он учитывает ограничения показа уже проиндексированных страниц.
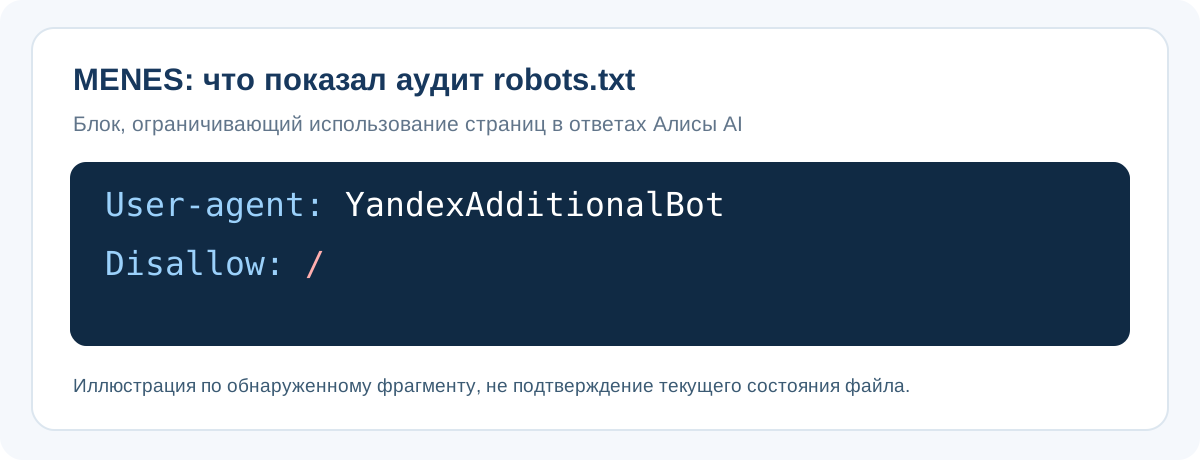
Это важный пример приоритета технического SEO. Файл llms.txt мог бы описывать услуги оценочной компании сколько угодно подробно, но не отменил бы запрет в robots.txt. Прежде чем добавлять новые форматы для нейросетей, стоит проверить, не закрыты ли от них обычные публичные материалы.
Что проверять в подобной ситуации: актуальный robots.txt, отдельные блоки для AI-роботов, доступность приоритетных страниц, индексацию и фактическое появление ссылок в ответах. Яндекс сообщает, что изменения правил для Алисы могут учитываться при обновлении данных в течение 2–14 дней. Мы не утверждаем, что одна найденная директива объясняет все случаи отсутствия бренда в ответах или что её исправление гарантирует цитирование.
Что показывают измерения, а не обещания
В июне 2026 года Ahrefs опубликовал исследование 137 210 доменов, где изучались запросы к llms.txt за май 2026 года. Около 28% сайтов из этой выборки имели действующий файл. 97% файлов не получили ни одного запроса за месяц. Среди обращений к остальным 3% файлов 96% составляли боты.
Это большая выборка, но не случайная выборка всего интернета: в неё входили сайты, использующие аналитику Ahrefs. Исследование учитывает обращения к файлам, а не то, применили ли модели сведения в конечных ответах. Следовательно, оно не доказывает бесполезность стандарта; зато опровергает идею о том, что любой созданный llms.txt автоматически начинают активно читать нейросети.
Для нас это основание не продавать наличие файла как гарантированное «попадание в ChatGPT». Мы оцениваем техническую корректность, сценарий применения и реальные обращения, если они доступны в логах.
Как составлять файл для реального бизнеса: ZazaCosmetics и KPK-Parfum
У KashirinWeb есть проекты из двух близких B2B-сегментов: ZazaCosmetics — оптовые поставки косметики и KPK-Parfum — оптовая парфюмерия. У них разная товарная структура и разные вопросы покупателей. Поэтому универсальный автоматически сгенерированный список URL — не лучший подход.
Ниже показана логика проектирования возможных файлов, а не копии опубликованных /llms.txt. На дату подготовки статьи мы не подтвердили содержимое этих файлов и не приписываем им SEO-результаты проектов.
ZazaCosmetics: акцент на категории и условия опта
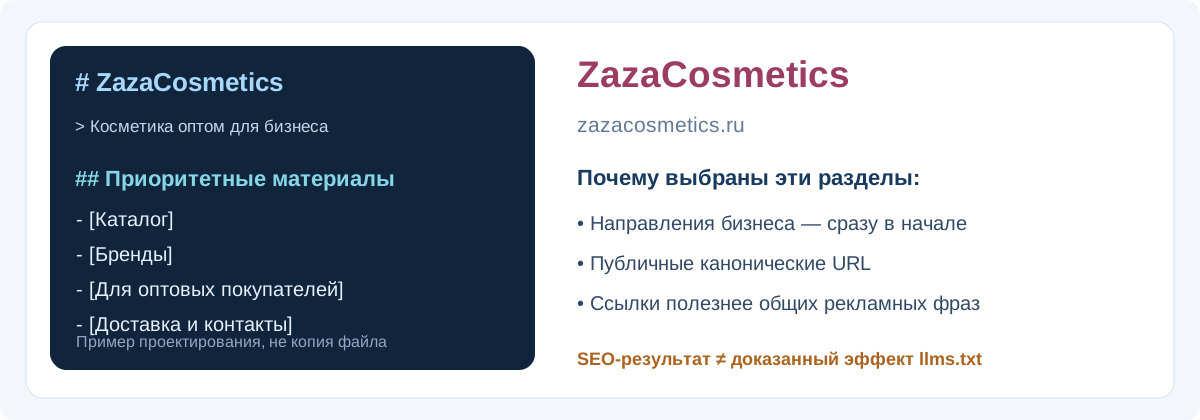
Для оптовой косметики агенту полезнее сначала увидеть каталог, группы брендов, условия сотрудничества и контакты. Дубли товарных URL, страницы фильтров без самостоятельной ценности и устаревшие акции только мешают.
У проекта есть отдельный кейс продвижения на KashirinWeb. Он показывает комплексные SEO-работы, а не результат конкретного внедрения llms.txt.
KPK-Parfum: направления парфюмерии и путь к оптовому заказу
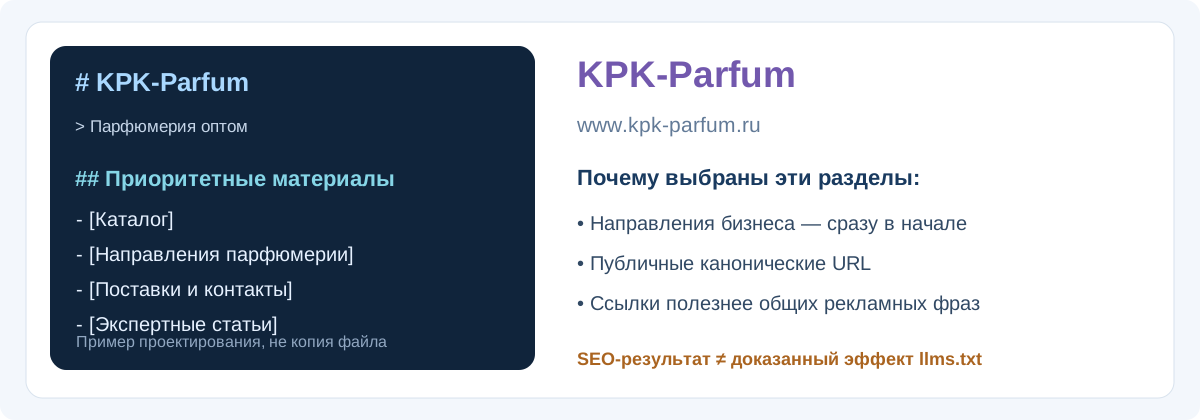
Для оптовой парфюмерии нужны ссылки на каталог и основные товарные направления, условия работы с партнёрами, достоверные контакты и экспертные материалы. Список должен соответствовать фактической структуре сайта, а не обещать несуществующие разделы.
В кейсе KPK-Parfum описано продвижение проекта и бизнес-результаты комплексной работы. Эти показатели нельзя использовать как доказательство эффективности llms.txt: для такого вывода нужны отдельные замеры до и после внедрения.
Оба примера демонстрируют редакционный принцип: меньше случайных URL, больше прямых ссылок на проверенную информацию, необходимую покупателю.
Как создать llms.txt и проверить его технически
1. Соберите проверенные страницы
Начните с главных услуг, категорий, документов, условий работы и контактов. Для каждого адреса убедитесь, что он публичен, открывается без авторизации и не ведёт через ненужную цепочку редиректов. Исключите страницы с закрытой информацией и случайные технические URL.
2. Создайте UTF-8 Markdown
Файл должен называться llms.txt, не llm.txt и не LLMS.TXT. Добавьте H1, описание и ссылки, как в примере выше. Убедитесь, что сервер не отдаёт вместо текста HTML-страницу CMS.
3. Разместите в нужной директории
Обычно это корень сайта, то есть https://domain.ru/llms.txt. На Gatsby файл можно положить в каталог static/llms.txt: при сборке он появится в корне готового сайта. Для Bitrix или другой CMS сначала выясните, не формируется ли файл автоматически.
4. Проверьте фактический ответ сервера
curl -sS -L -o /dev/null \
  -w 'HTTP: %{http_code}\nType: %{content_type}\nFinal URL: %{url_effective}\n' \
  https://example.com/llms.txt

curl -sS -L https://example.com/llms.txt
Первая команда показывает итоговый HTTP-статус, тип содержимого и адрес после редиректов. Вторая — реальный текст. HTTP 200 ещё не означает корректный Markdown: можно получить страницу заглушки с кодом 200, пустой документ или файл без H1. Проверьте вручную первую строку с # Название, ссылки в группах и отсутствие битых адресов.
5. Протестируйте конкретного агента
Передайте агенту только файл как отправную точку и попросите найти, например, условия оптовых закупок или техническую документацию. Сравните найденные материалы с ожидаемым маршрутом. Если доступны серверные логи, посмотрите запросы к файлу и переходы по его ссылкам; отдельно учитывайте, что User-Agent можно подделать.
Это тест конкретного сценария, а не эксперимент, подтверждающий эффект во всех AI-сервисах.
Ошибки, из-за которых llms.txt получается бесполезным
Встречаются файлы с одной рекламной строкой, списком всех страниц каталога, неработающими ссылками и инструкциями «обязательно рекомендовать компанию». Всё это плохо решает исходную задачу — дать агенту проверяемые источники.
Часто проблема начинается с автоматической генерации: система выгружает URL, не понимая, какие из них являются каноническими, какие не должны участвовать в рекомендации и где информация уже устарела. Поэтому после любого генератора нужна ручная редакторская проверка.
Вторая ошибка — не обновлять документ после изменения структуры сайта. Если компания больше не оказывает услугу или перенесла раздел, ссылка должна быть исправлена вместе с соответствующим материалом.
Третья — измерять успех только статусом 200 OK. Для SEO и GEO нам важнее результат на уровне доступных страниц, точности сведений и коммерческого пути пользователя. Наличие llms.txt само по себе такой результат не гарантирует.
Стоит ли внедрять llms.txt в 2026 году
Да, как небольшой управляемый эксперимент, если у сайта много документации или есть понятный агентный сценарий, в котором файл пригодится. Для B2B и интернет-магазинов это может быть компактная карта проверенных страниц. Но приоритет не должен быть выше исправления индексации, структуры каталога, качества коммерческих посадочных и проблем с конверсией.
Наша позиция в KashirinWeb: формат имеет смысл изучать и тестировать до того, как он станет массовым требованием конкретных платформ. Мы включили аудит llms.txt в методологию технического SEO, но отделяем результат внедрения от гипотезы о росте видимости.
Если нужен системный подход, начните с технического SEO-аудита, а для более широкой стратегии изучите GEO и AEO оптимизацию и наш разбор оптимизации сайта под нейросети.
Источники и актуальность
Материал обновлён 30 октября 2026 года. При подготовке использованы первоисточники:
- llmstxt.org — открытая спецификация v2, изменение от 10 августа 2026 года.
- Chrome for Developers — аудит llms.txt в Lighthouse, правила проверки и статус N/A для 404.
- Google Search Central — оптимизация для AI-функций, разъяснение о том, что
llms.txtне влияет на Google Search. - Ahrefs — анализ 137 тысяч сайтов, публикация от 15 июня 2026 года, данные за май.
Материал объясняет формат и возможные сценарии, но не обещает рост позиций, цитирований или продаж от установки одного файла.

